Consultant SEO freelance · 15 ans d’expérience · Dernière mise à jour : mars 2026
L’analyse de logs SEO n’a jamais été aussi critique : entre mai 2024 et mai 2025, Googlebot a doublé son activité (+96 % de requêtes selon le rapport Cloudflare de juillet 2025), tandis que GPTBot a explosé de 305 %.
En 15 ans de SEO, j’ai vu des dizaines de sites stagner sans raison apparente — Search Console propre, contenu à jour, pas d’erreur visible. Les logs ont presque toujours donné la réponse. Pas une estimation, pas un échantillon : la réalité brute de ce que les robots font sur votre site.
En bref
- L’analyse de logs étudie les fichiers bruts de votre serveur pour voir 100 % des visites de robots — là où la Search Console ne montre qu’un échantillon.
- Elle révèle le gaspillage de budget de crawl, les erreurs invisibles et les pages stratégiques ignorées par Google.
- En 2026, elle couvre aussi les crawlers IA (GPTBot, ClaudeBot, PerplexityBot) qui consomment vos ressources serveur.
- Ce guide couvre la méthode complète : définition, 10 indicateurs clés, outils, étapes concrètes et cas pratique terrain.
Qu’est-ce que l’analyse de logs en SEO ?
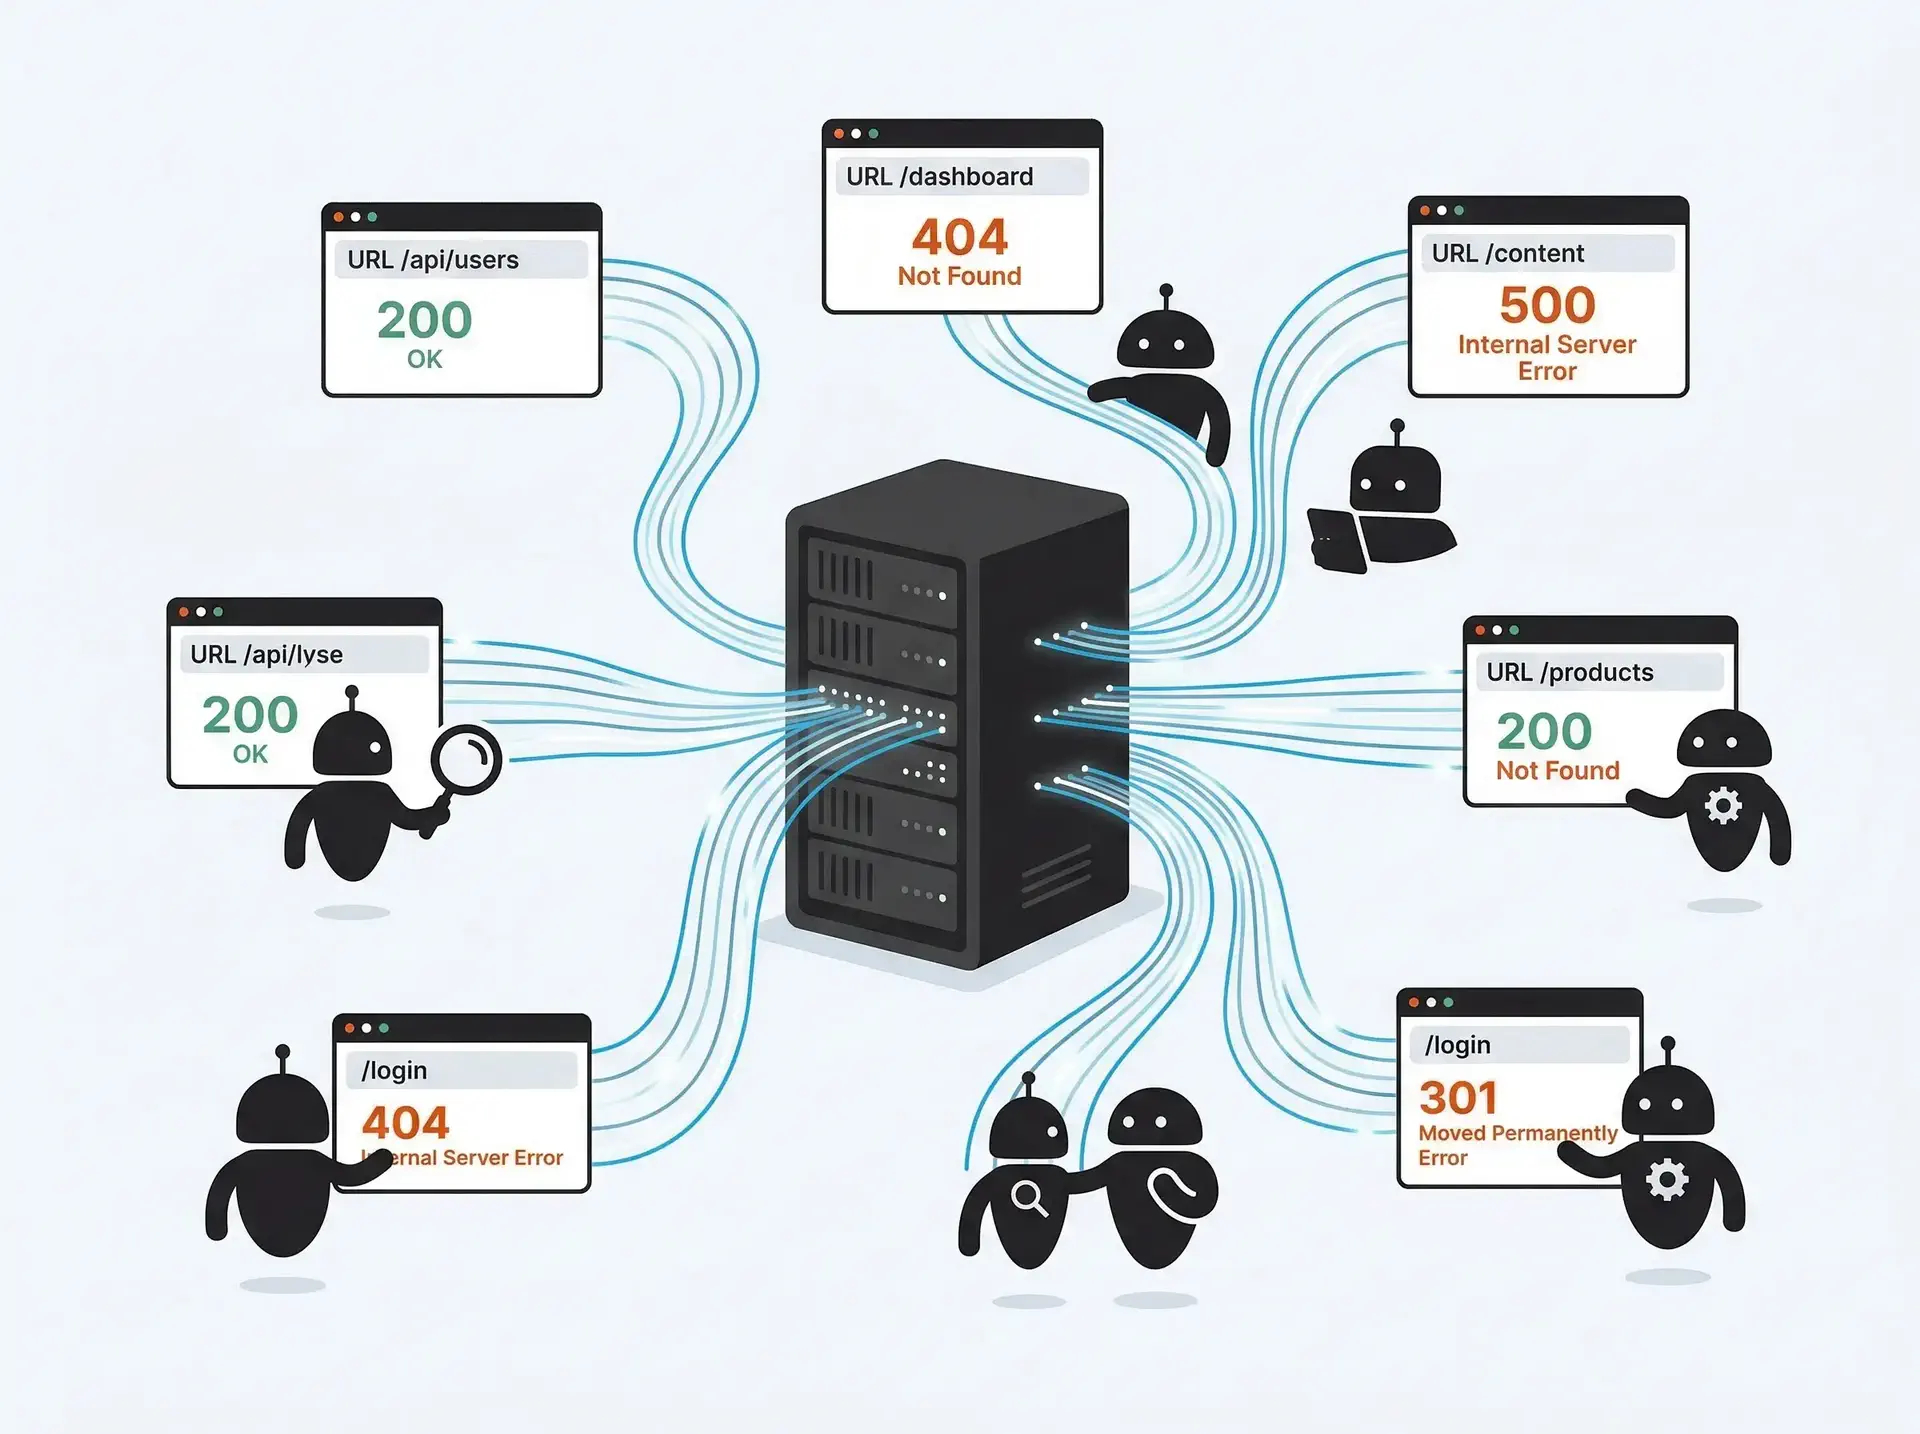
Votre serveur web — Apache, Nginx, IIS ou autre — enregistre chaque requête reçue dans un fichier texte appelé fichier de log (ou journal d’accès). Chaque visite d’un humain, chaque passage de Googlebot, chaque tentative de GPTBot : tout y est, ligne par ligne.
L’analyse de logs en SEO, c’est lire et exploiter ces fichiers pour comprendre comment les robots d’exploration interagissent avec votre site. Quelles pages ils visitent. Lesquelles ils ignorent. Quelles erreurs ils rencontrent. À quelle fréquence ils reviennent.
Ni Google Analytics, ni la Search Console ne fournissent ces informations de manière complète. Analytics repose sur un tag JavaScript — les robots ne l’exécutent pas. La Search Console propose un rapport d’exploration, mais c’est un échantillon filtré. Les logs, eux, capturent tout. C’est la source de vérité. Les deux restent complémentaires : la Search Console montre le résumé que Google veut bien vous donner, les logs montrent ce qui s’est réellement passé sur votre serveur.
À quoi ressemble une ligne de log ?
Voici un exemple au format Apache Combined :
66.249.66.1 - - [12/Mar/2026:09:15:32 +0100] "GET /services/ HTTP/1.1" 200 14523 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"
Chaque élément raconte quelque chose. 66.249.66.1 est l’adresse IP — une IP Google. [12/Mar/2026:09:15:32] donne la date et l’heure exactes. GET /services/ indique la page demandée. 200 confirme que le serveur a répondu correctement. 14523 correspond au poids en octets. Et le user-agent identifie Googlebot 2.1.
Une seule ligne = une visite documentée. Multipliez par des milliers de lignes par jour, et vous obtenez la carte complète de l’activité des robots sur votre site.
💡 Conseil
Si vous êtes sur un hébergement mutualisé et que vous n’avez pas accès aux logs bruts, contactez votre hébergeur. La plupart (OVH, o2switch, Infomaniak) proposent un accès via le panneau d’administration ou par FTP dans le dossier /logs/.
Pourquoi analyser vos logs en 2026
Le budget de crawl : un capital limité
Google n’a pas un temps illimité à consacrer à votre site. Le budget de crawl représente le nombre de pages que Googlebot accepte d’explorer lors de chaque passage. Quand ce budget est consommé par des pages sans valeur — filtres, paramètres de tri, paginations infinies — vos pages stratégiques sont repoussées au passage suivant. Ou au suivant. Ou jamais.
Les sites volumineux peuvent gaspiller jusqu’à 40 % de leur budget de crawl sur des URLs sans valeur : filtres, tags, paramètres de session et contenus dupliqués.
L’analyse de logs est le seul moyen de mesurer cette répartition avec précision. Combien de requêtes Googlebot consacre-t-il à vos pages produits ? À vos pages de recherche interne ? À vos redirections ? Sans ces chiffres, vous corrigez à l’aveugle.
Les problèmes que la Search Console ne montre pas
La Search Console signale les erreurs d’indexation. Les logs montrent les erreurs de crawl — ce qui se passe avant l’indexation. Un fichier CSS bloqué par le robots.txt, un JavaScript qui renvoie un timeout, une image qui répond systématiquement en erreur 403 : autant de problèmes qui empêchent Google de comprendre correctement vos pages, et que la Search Console ne remonte pas.
Les logs révèlent aussi les pages orphelines — des URLs que les robots connaissent et visitent, mais qui ne sont reliées à rien dans votre maillage interne. Impossible de les trouver avec un crawler SEO classique, puisque celui-ci suit les liens. Seuls les logs montrent que Googlebot accède à ces pages fantômes.
C’est un scénario que je rencontre régulièrement chez mes clients en Île-de-France : des pages de services qui ne reçoivent aucune visite de Googlebot, alors que des URLs parasites générées par un plugin captent toute l’attention du robot. La Search Console ne sonne aucune alarme. Les logs, si.
La nouvelle donne : les crawlers IA dans vos logs
C’est la dimension que la plupart des guides SEO en français n’abordent pas encore. Et c’est un angle mort dangereux.
Le rapport Cloudflare 2025 montre que le trafic total des robots (search + IA) a grimpé de 18 % en un an. GPTBot est passé de 2,2 % à 7,7 % du trafic crawlers. PerplexityBot a bondi de 157 490 %. ChatGPT-User de 2 825 %. Ces chiffres sont vertigineux.
Ces robots consomment vos ressources serveur. Ils sollicitent votre bande passante. Et selon vos choix, ils récupèrent votre contenu pour entraîner leurs modèles ou alimenter leurs réponses.
L’analyse de logs vous donne les faits : quel bot IA visite votre site, à quelle fréquence, sur quelles pages. Vous décidez ensuite si vous les autorisez (via le robots.txt) ou si vous les bloquez. Pas d’opinion. Des données.
À lire aussi :
Optimisation SEO WordPress : boostez votre visibilité en ligne →
Les 10 indicateurs clés à surveiller dans vos logs
Tous les indicateurs n’ont pas la même importance selon votre site. Un site vitrine de 50 pages n’a pas les mêmes enjeux qu’un e-commerce de 200 000 fiches produits. Voici les 10 métriques que je surveille systématiquement chez mes clients, classées par priorité.
| # | Indicateur | Ce qu’il révèle | Signal d’alerte |
|---|---|---|---|
| 1 | Volume de crawl quotidien | L’intérêt global de Google pour votre site | Chute de +50 % sur 48h |
| 2 | Répartition par code HTTP | Proportion de 200, 301, 404, 500 | Plus de 5 % de codes 4xx ou 5xx |
| 3 | Ratio pages actives / pages crawlées | Le gaspillage de budget de crawl | Moins de 60 % de pages actives crawlées |
| 4 | Fréquence de crawl par page | L’importance SEO perçue de chaque page | Page stratégique crawlée <2 fois/mois |
| 5 | Fenêtre de crawl | Nombre de jours pour explorer toutes vos URLs | Fenêtre >30 jours (hors très gros sites) |
| 6 | Temps de réponse serveur | La rapidité perçue par le robot | TTFB moyen >500 ms |
| 7 | Crawl mobile vs desktop | Si votre site est dans l’index Mobile First | Ratio mobile <80 % des requêtes Googlebot |
| 8 | Pages orphelines | Pages crawlées mais absentes du maillage interne | Présente dans les logs, absente du crawl SEO |
| 9 | Ressources bloquées (CSS, JS, images) | Problèmes de rendu pour Google | Codes 403/404 sur fichiers .css ou .js |
| 10 | Volume des crawlers IA | Charge des bots IA sur vos ressources serveur | GPTBot ou ClaudeBot >10 % du trafic bot total |
Comment analyser vos logs : 4 étapes concrètes
Étape 1 — Récupérer les fichiers de logs
Connectez-vous à votre serveur en FTP ou SSH et récupérez les fichiers access.log (Apache) ou access_log (Nginx). Sur un hébergement mutualisé type OVH ou o2switch, rendez-vous dans le panneau cPanel > section « Metrics » > « Raw Access Logs ». Exportez au minimum 30 jours de données — idéalement 60 — pour avoir assez de recul.
Si votre site passe par un CDN (Cloudflare, Fastly), pensez à récupérer les logs côté CDN aussi. Les requêtes mises en cache n’atteignent pas toujours votre serveur d’origine, et vous rateriez une partie de l’activité des robots.
Étape 2 — Filtrer par user-agent
Le fichier brut mélange les visites humaines et les robots. Première action : isoler les user-agents qui vous intéressent. Pour le SEO, filtrez au minimum Googlebot, Googlebot-Mobile, Bingbot. En 2026, ajoutez GPTBot, ClaudeBot, PerplexityBot, ChatGPT-User et Meta-ExternalAgent.
Un user-agent peut être falsifié. N’importe qui peut se faire passer pour Googlebot. Pour vérifier, un reverse DNS sur l’IP doit renvoyer un domaine .googlebot.com ou .google.com. Tous les outils d’analyse de logs sérieux font cette vérification automatiquement.
Étape 3 — Croiser avec le sitemap et le crawl SEO
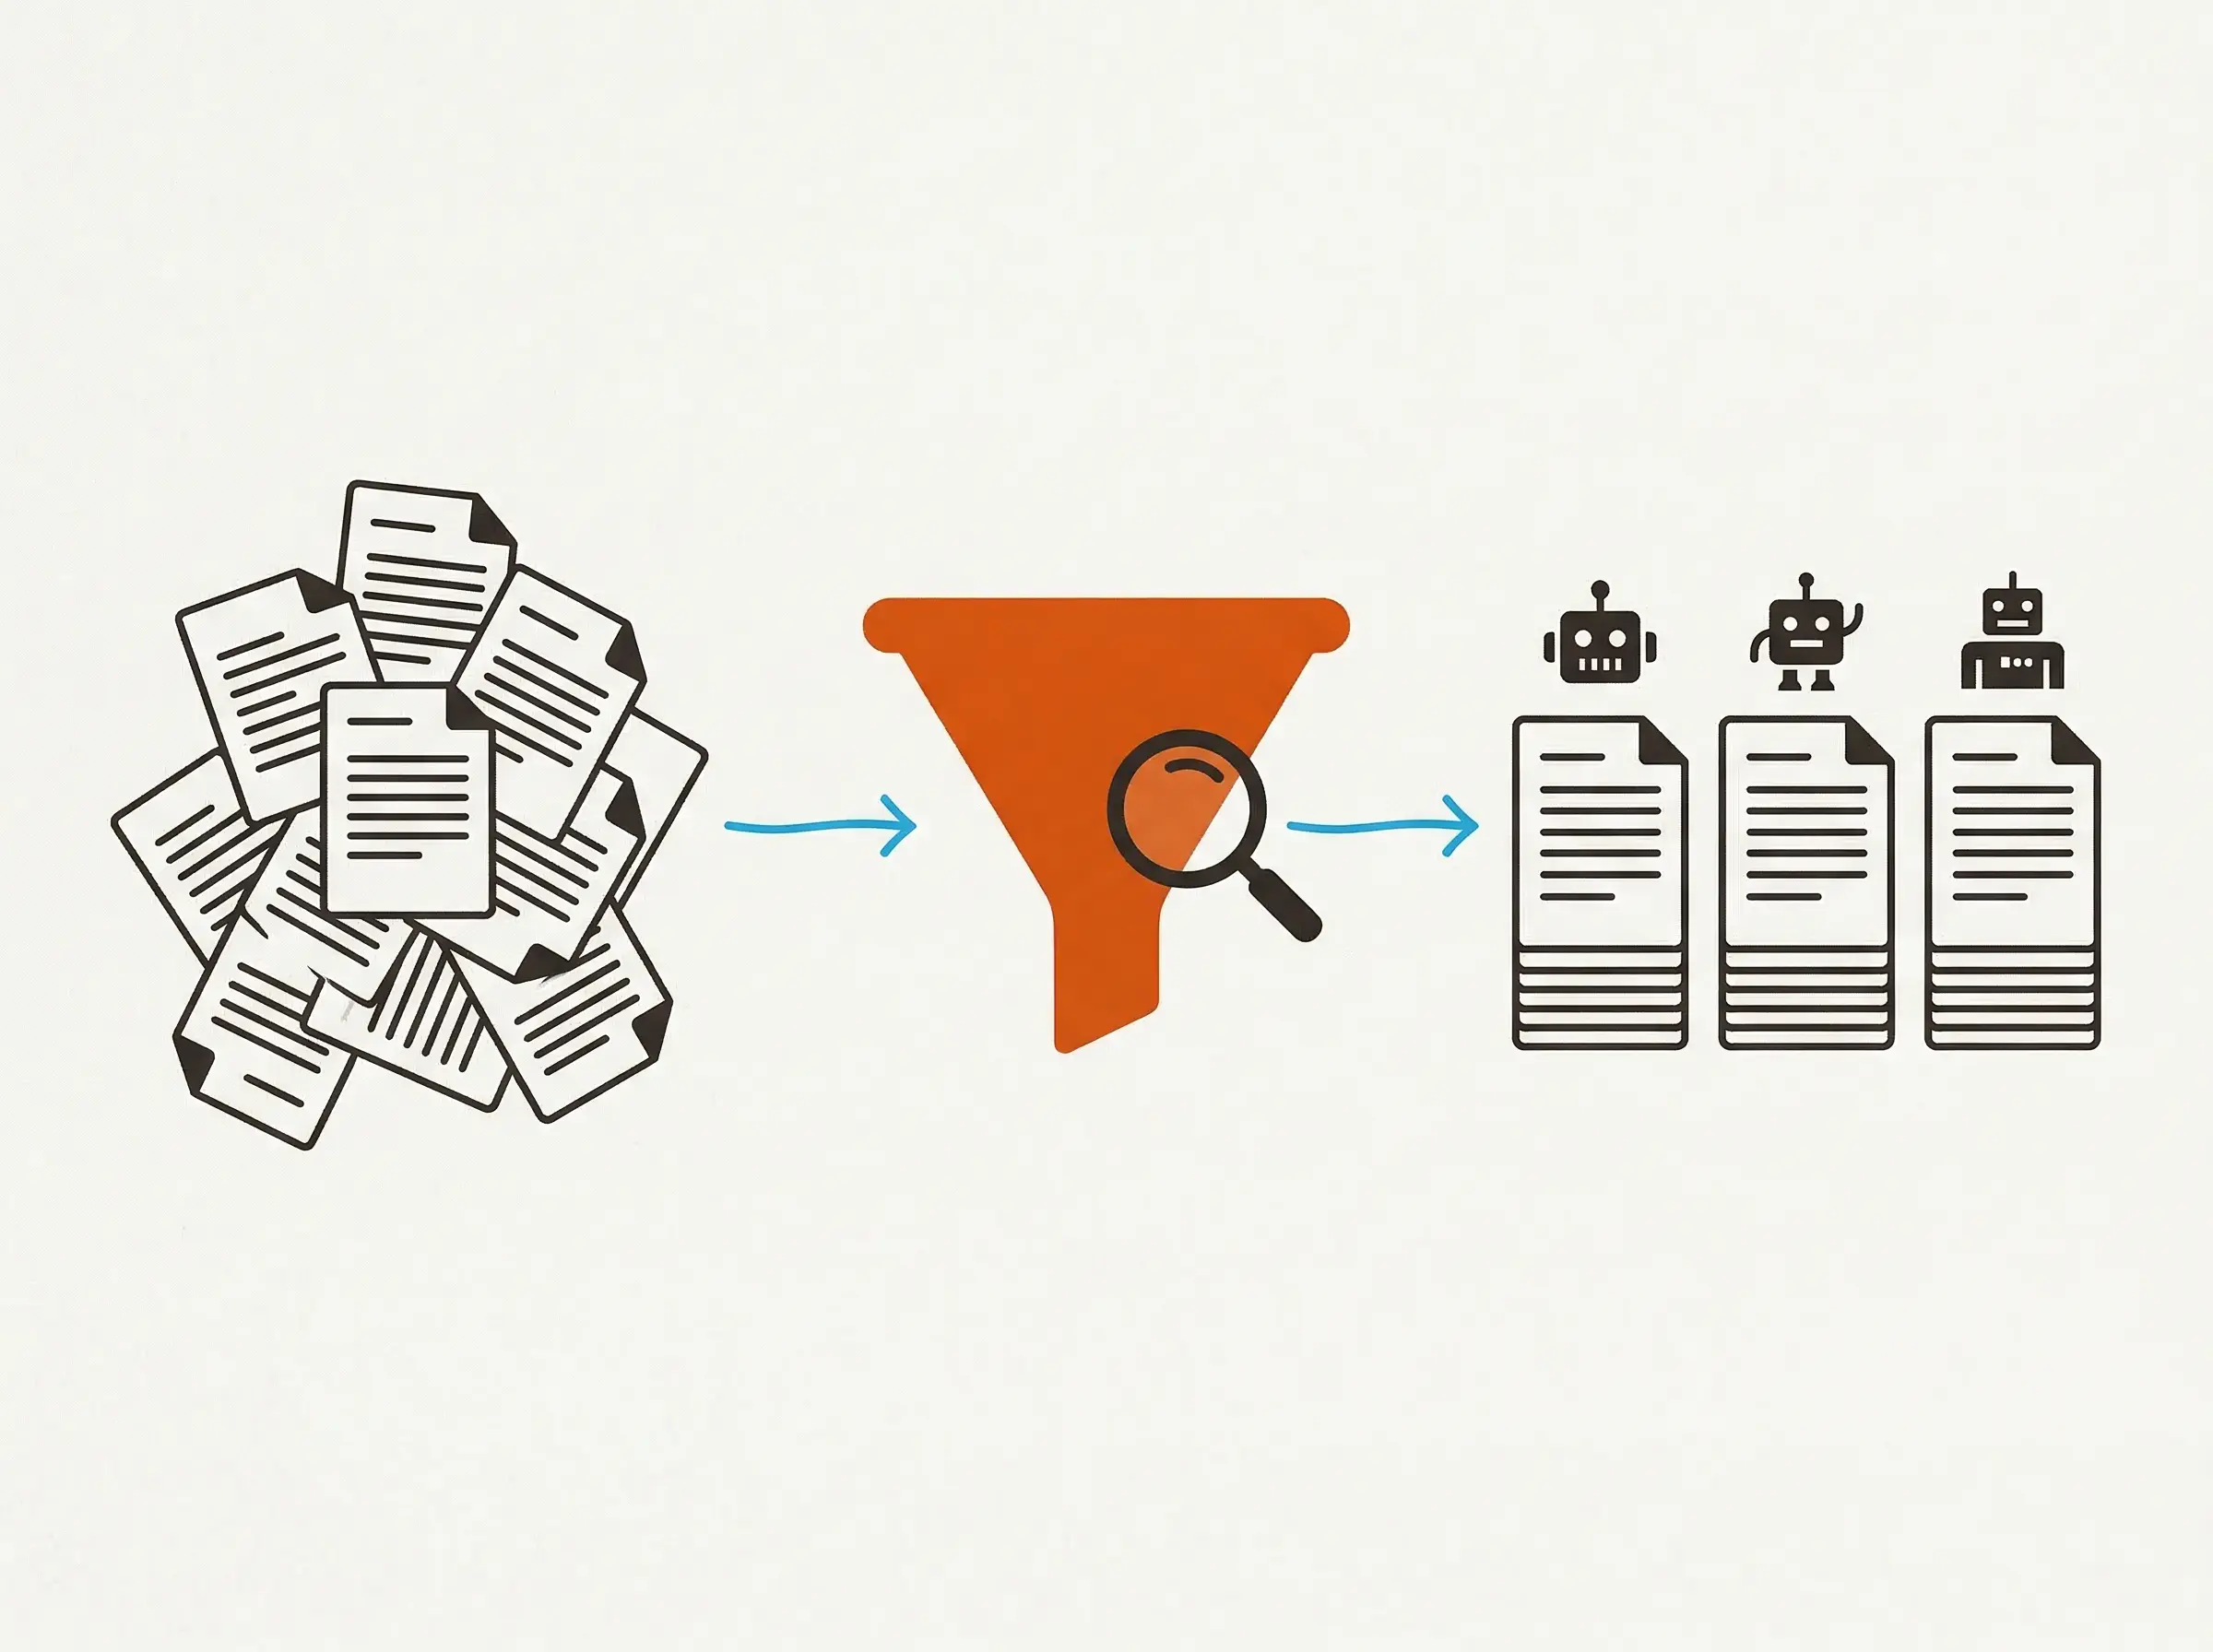
C’est ici que la vraie valeur apparaît. Prenez trois listes : les URLs de votre sitemap XML, les URLs trouvées par un crawler SEO (Screaming Frog Spider, par exemple), et les URLs visitées par Googlebot dans les logs. Croisez-les.
Trois situations se dessinent :
| Situation | Sitemap | Crawl SEO | Logs Googlebot | Diagnostic |
|---|---|---|---|---|
| /services/ | ✓ Présente | ✓ Trouvée | ✓ Crawlée | Tout fonctionne — aucune action |
| /offre-pro/ | ✓ Présente | ✓ Trouvée | ✗ Absente | Page ignorée — vérifier profondeur + maillage |
| /promo-2024/ | ✗ Absente | ✗ Absente | ⚠ Crawlée | Page orpheline — rattacher ou supprimer |
La deuxième ligne est la plus frustrante et la plus fréquente. Votre page est dans le sitemap, votre crawler la trouve, mais Googlebot ne vient jamais. La cause est souvent un maillage interne trop faible : pas assez de liens internes pointent vers cette page, ou les liens qui existent sont trop profonds dans l’arborescence.
Étape 4 — Identifier les anomalies et prioriser
Classez les problèmes par impact business. Une page de service qui génère du CA mais n’est crawlée que deux fois par mois passe en priorité 1. Un bloc de 500 URLs paramétrées qui consomme 30 % du crawl passe en priorité 2 (blocage robots.txt ou canonical). Les erreurs 500 répétées passent en priorité 3 — elles signalent une instabilité serveur que Google pénalise sur la durée.
⚠️ Attention
Ne bloquez jamais vos fichiers CSS et JavaScript dans le robots.txt. Google en a besoin pour effectuer le rendu de vos pages. Si ces ressources renvoient des erreurs 403 ou 404 dans vos logs, votre page risque d’être interprétée comme vide — même si elle est remplie de contenu côté navigateur.
Les meilleurs outils d’analyse de logs en 2026
Les fichiers de logs pèsent plusieurs gigaoctets sur un site actif. Les ouvrir dans un éditeur de texte, c’est comme chercher une adresse dans un annuaire de 800 pages. Il vous faut un outil dédié.
| Outil | Type | Prix | Idéal pour | Détecte les bots IA |
|---|---|---|---|---|
| Screaming Frog Log Analyzer | Desktop | £99/an | Sites <100k pages, audits ponctuels | Oui |
| Oncrawl | SaaS cloud | À partir de 49 €/mois | Sites >100k pages, croisement crawl+logs | Oui |
| JetOctopus | SaaS cloud | À partir de 60 $/mois | Gros sites, logs en temps réel | Oui |
| Seolyzer | SaaS (français) | Gratuit (limité) / payant | Monitoring temps réel, alertes | Partiel |
| GoAccess | Open source (terminal) | Gratuit | Premier diagnostic, petit budget | Manuel |
💡 Conseil
Pour un site vitrine WordPress de moins de 500 pages, Screaming Frog Log Analyzer suffit largement. La licence annuelle couvre aussi le crawler SEO Spider — vous faites le croisement crawl + logs avec un seul outil et un seul abonnement à £199/an.
Cas pratique : ce que les logs ont révélé sur un site vitrine en Yvelines
Je partage ce cas parce qu’il illustre exactement le type de problème que les logs dévoilent — et que tous les autres outils ratent.
Un client PME avec un site d’environ 80 pages m’a sollicité parce que ses positions stagnaient depuis 6 mois. J’ai commencé par les vérifications habituelles. Search Console : aucune erreur d’exploration signalée. Screaming Frog Spider : architecture propre, pas de lien cassé, balises en ordre. En apparence, tout allait bien.
Les logs ont raconté une autre histoire.
Sur 30 jours, Googlebot avait effectué environ 400 requêtes sur le site. Jusque-là, rien de surprenant pour un petit site. Le problème : 65 % de ces requêtes ciblaient des URLs générées par le moteur de recherche interne WordPress — des centaines de variations de type /?s=mot-clé. Les 7 pages de services, celles censées générer des prospects, ne recevaient que 2 à 3 visites Googlebot par mois chacune.
Le budget de crawl était aspiré par des pages fantômes. Et c’est frustrant, parce que la réponse était là depuis le début — il suffisait de regarder les logs.
Trois actions, déployées en une semaine :
- →
Blocage des URLs/?s=dans le robots.txt - →
Ajout de liens internes depuis chaque article de blog vers les pages de services - →
Soumission d’un sitemap XML nettoyé (uniquement les pages utiles)
Six semaines plus tard, la fréquence de crawl des pages de services avait été multipliée par quatre. Deux d’entre elles étaient passées de la page 3 à la page 1 sur leurs requêtes cibles.
Ce diagnostic était impossible sans les logs. Point.
Installer un suivi continu de vos logs
Un audit ponctuel est utile. Un suivi continu change la donne. Les problèmes techniques n’envoient pas de faire-part : ils apparaissent après une mise à jour de plugin, un changement serveur, un déploiement qui a modifié le robots.txt sans que personne ne s’en rende compte.
J’ai vu un client perdre 40 % de son crawl Googlebot du jour au lendemain parce qu’une mise à jour de son plugin de cache avait injecté une directive Disallow: / dans le robots.txt. La Search Console a mis 5 jours à signaler le problème. Les logs l’auraient montré en 24 heures avec une alerte automatique.
Trois alertes à configurer en priorité :
- →
Chute du volume de crawl — si Googlebot divise ses requêtes par deux sur 48 heures, quelque chose bloque : serveur lent, robots.txt modifié, erreurs 5xx en série. - →
Hausse des erreurs serveur — plus de 5 % de codes 500 sur une journée indique une instabilité. Google réduit son crawl quand le serveur lui répond mal. - →
Explosion d’une catégorie d’URLs — un plugin qui génère subitement des centaines de nouvelles URLs capte le crawl au détriment du reste du site.
Des outils comme Seolyzer ou JetOctopus intègrent ces alertes nativement. Pour les sites plus petits, un script cron qui analyse les logs quotidiens et envoie un email en cas d’anomalie fait le travail.
À lire aussi :
Diagnostic SEO Flash : un état des lieux complet en 5 jours →
Questions fréquentes
Qu’est-ce que l’analyse de logs en SEO ?
C’est l’étude des fichiers d’accès enregistrés par votre serveur web (Apache, Nginx) pour voir exactement quelles pages les robots d’exploration comme Googlebot visitent, à quelle fréquence, et avec quel résultat technique. Contrairement à Google Analytics ou la Search Console, les logs capturent 100 % des requêtes sans échantillonnage.
Quels outils utiliser pour analyser ses logs ?
Les principaux sont Screaming Frog Log Analyzer (£99/an, idéal pour les sites de moins de 100 000 pages), Oncrawl (à partir de 49 €/mois, croisement crawl + logs pour les gros sites), JetOctopus (à partir de 60 $/mois, logs en temps réel), Seolyzer (outil français avec alertes automatiques) et GoAccess (gratuit, open source, premier diagnostic rapide).
Comment récupérer les logs de son serveur ?
Sur un hébergement mutualisé (OVH, o2switch, Infomaniak), accédez au panneau cPanel > section Metrics > Raw Access Logs. Sur un serveur dédié, connectez-vous en SSH ou FTP et récupérez les fichiers access.log (Apache) ou access_log (Nginx). Exportez au minimum 30 jours de données. Si votre site passe par un CDN, récupérez aussi les logs côté CDN.
Quand faut-il analyser les logs de son site ?
Quatre situations rendent l’analyse de logs utile : lors d’une baisse de trafic inexpliquée, après une refonte ou une migration, quand des pages stratégiques ne s’indexent pas malgré un contenu de qualité, et pour les sites de plus de 10 000 pages qui doivent surveiller leur budget de crawl de façon continue.
Les crawlers IA comme GPTBot apparaissent-ils dans les logs ?
Oui. Les crawlers IA (GPTBot, ClaudeBot, PerplexityBot, ChatGPT-User, Meta-ExternalAgent) laissent une trace dans vos logs via leur user-agent, exactement comme Googlebot. Selon le rapport Cloudflare de juillet 2025, GPTBot a bondi de 305 % entre mai 2024 et mai 2025. L’analyse de logs mesure leur charge sur vos ressources serveur et vous aide à décider si vous les autorisez ou les bloquez via le robots.txt.
Ce qu’il faut retenir
✓ L’essentiel
- L’analyse de logs est la seule source de données complète et non échantillonnée sur le comportement des robots sur votre site.
- Elle répond à trois questions : quelles pages sont crawlées, à quelle fréquence, et avec quel résultat technique.
- En 2026, elle couvre un nouveau territoire : les crawlers IA qui consomment vos ressources serveur sans que vous le sachiez.
- La méthode : récupérer les logs → filtrer par user-agent → croiser avec sitemap et crawl → prioriser les corrections.
- Un suivi continu protège contre les régressions techniques silencieuses — celles qui coûtent des positions avant même que vous ne les remarquiez.
Les logs ne mentent pas. Ils ne filtrent pas. Ils n’échantillonnent pas. Ils enregistrent chaque requête, chaque code de réponse, chaque passage de robot.
Tout le reste, c’est de la supposition.
Vous voulez savoir ce que Google voit sur votre site ?
L’analyse de logs fait partie de mes audits techniques. En 5 jours, vous savez où le crawl se perd, quelles pages sont ignorées, et quoi corriger en priorité.
📚 Ressources et sources
- Cloudflare — From Googlebot to GPTBot (juillet 2025) — Données sur l’activité des crawlers search et IA
- Web Almanac 2024, chapitre SEO — HTTP Archive — Analyse de 17 millions de sites, crawlabilité et indexabilité
- Documentation Google — What Is Googlebot — Référence officielle sur la vérification de Googlebot
- Screaming Frog Log File Analyser — Outil d’analyse de logs desktop
- Oncrawl SEO Log Analyzer — Solution SaaS française, croisement crawl + logs
- Google — Crawl Budget Management — Guide officiel sur la gestion du budget de crawl
Articles liés :
 Stratégie Marketing Digital 2025: Le Guide Ultime pour les Entrepreneurs
 Comment booster ses réservations de location de voiture à PTP : les secrets d’une croissance explosive de +180 % en 5 mois
 Quels plugins SEO WordPress choisir pour votre site vitrine local ?
 SEO aux Antilles en 2025 : Le Guide Ultime pour Booster Votre Visibilité